Qwen Audio Agent 端到端实现解剖:从本地音频 Gateway 到异步后台 Agent
核心结论
qwen-audio-agent不是 Qwen Audio 模型本身的开源推理实现,而是一个把实时语音模型、客户端音频、工具、长期任务和既有编码 Agent 连接起来的本地运行时。它最值得借鉴的创新,不是“把麦克风接到模型”,而是把交互拆成两个时间尺度:Realtime Frontstage 维持百毫秒级、可打断的对话;Gateway 把深度工作转成持久 Task,交给 ACP/A2A 后台 Agent,在安全播报窗口把结果重新注入语音会话。它已经实现了较完整的生成取消、客户端清空、迟到输出抑制、任务恢复和结果通知语义;但 Web 客户端仍使用 PCM16 Base64 over WebSocket,且源码中没有发现按实际可听位置执行conversation.item.truncate的证据。因此,它是很有辨识度的“个人桌面语音 Agent runtime”,还不是可直接替代 OpenAI WebRTC/SIP 或 LiveKit SFU 的通用生产媒体平台。
阅读前先分清
| 名词 | 在本文中的含义 |
|---|---|
| qwen-audio-agent | 本地语音 Agent runtime,不是 Qwen Audio 模型权重或自托管推理实现。 |
| Realtime Frontstage | 保持低延迟、可打断对话的前台回合。 |
| Gateway | 协调客户端、Realtime Provider、工具、Task 和后台结果回注的本机事实中心。 |
| TaskManager | 承载数十秒到数小时后台工作的持久任务状态机。 |
| Realtime Provider adapter | 隔离 DashScope 或本地 S2S 后端协议方言的适配层。 |
| 可听历史 | 用户已听到的内容;当前实现已能取消/清空,但未发现精确远端截断证据。 |
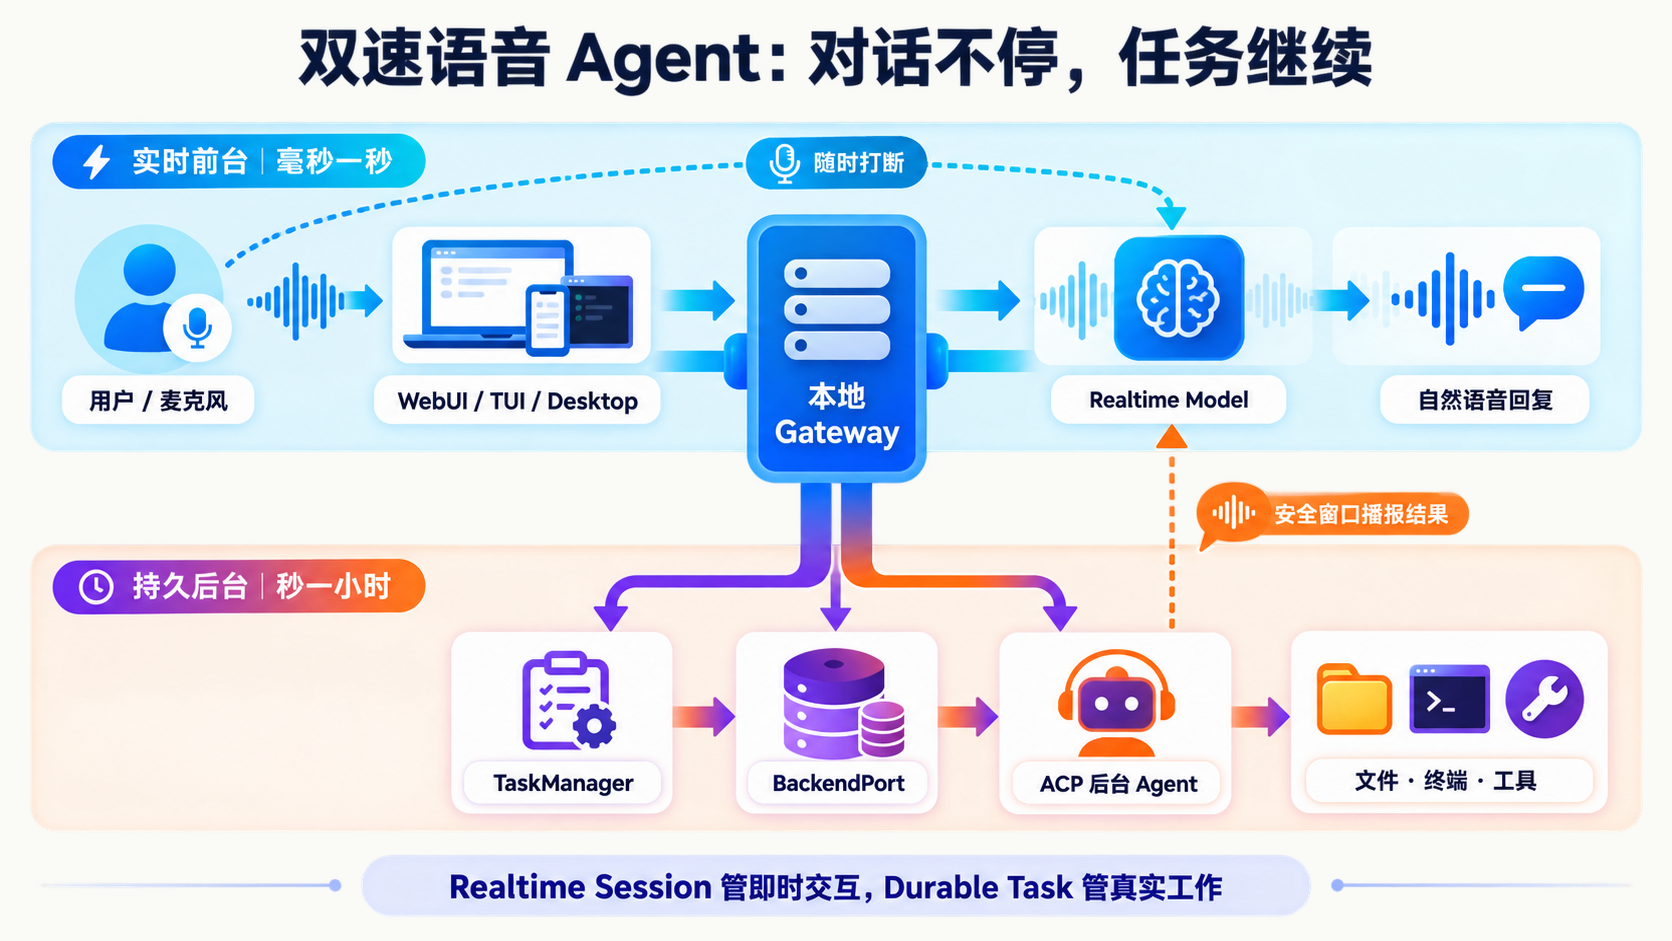
ImageGen 信息图:本报告的核心心智模型。实时前台负责可打断交互,持久后台负责真实工作,本地 Gateway 连接两个时间尺度。
1. 阅读方式与证据边界
本文以 QwenAudio/qwen-audio-agent 的固定提交 8565c03 为主要证据快照,提交时间为 2026-08-28。根包版本仍为 1.11.0,README 同时把 v2.0.0 标为开发中,因此本文分析的是 main 分支开发态,不是某个稳定 release 的能力承诺。
全文使用三类证据标签:
- [源码]:能由固定 commit 中的实现、测试或静态配置直接确认。
- [作者声明]:来自仓库 README、架构文档、隐私或配置说明;不自动等同于线上实测。
- [工程推断]:由数据路径、缓冲和状态机推导出的影响,需真实设备、网络或 Provider 验证。
本次验证做了三件事:
- 克隆固定提交并阅读 Web、TUI、Gateway、Realtime Provider、TaskManager、BackendPort、ACP、权限、记忆和安全关键路径。
- 在本机执行
npm ci、构建 Web 前端和完整npm test:共 1,344 项,1,343 通过、1 项跳过、0 失败。 - 对仓库两张官方架构图逐张目检并按 SHA-256 校验复制结果。
验证限制
本机 Node.js 为
25.2.1,不在项目声明的^22.22.2 || ^24.15.0 || >=26.0.0支持区间。测试通过证明固定源码在该环境下没有触发测试失败,不证明官方支持 Node 25。本文也没有使用真实 DashScope Key 建连,没有执行扬声器外放双讲、弱网、跨进程崩溃、多小时会话或生产压测。
2. 先澄清:这里的 “Qwen Audio” 到底是什么
qwen-audio-agent 容易被误读成三个不同东西:
| 对象 | 实际责任 | 是否在本仓库实现 |
|---|---|---|
| Qwen Audio / Qwen3.5 Omni Realtime 模型 | 流式听说、语义理解、工具决策、语音生成 | 否;默认通过 DashScope 托管服务调用 |
| Realtime API 协议适配 | session.update、音频 append、response、VAD、取消等事件 | 是;Provider adapter 封装协议方言 |
| qwen-audio-agent runtime | 客户端、Gateway、工具、后台任务、ACP、持久化、权限、记忆、桌面体验 | 是;这是仓库真正的主体 |
这一区分很重要。Apache-2.0 覆盖的是 Agent runtime 代码和仓库素材,不代表默认实时模型权重或 DashScope 托管推理链路也被开源。仓库还提供 speech-to-speech Provider,可连接本地 OpenAI GA 风格端点,将 VAD、STT、LLM、TTS 的模型选择交给该服务;这可以组成全本地链路,但它是可替换后端,不是仓库内置了一套原生 Qwen Audio 模型推理。
阿里云官方 Realtime 文档显示,Qwen Audio 3.0 与 Qwen3.5 Omni 的服务本身支持 WebSocket、WebRTC 等协议;而本仓库当前选择 客户端到本地 Gateway WebSocket,再由 Gateway 到 DashScope WebSocket。所以“Provider 能用 WebRTC”不等于“这个项目已经采用 WebRTC”。
3. 一句话架构:Realtime 前台不断线,后台任务不堵话
仓库早期概念图把设计浓缩成一条循环:实时模型维持自然聊天,把搜索、推理、编码等更深工作交给 Agent runtime,结果再回到实时模型。
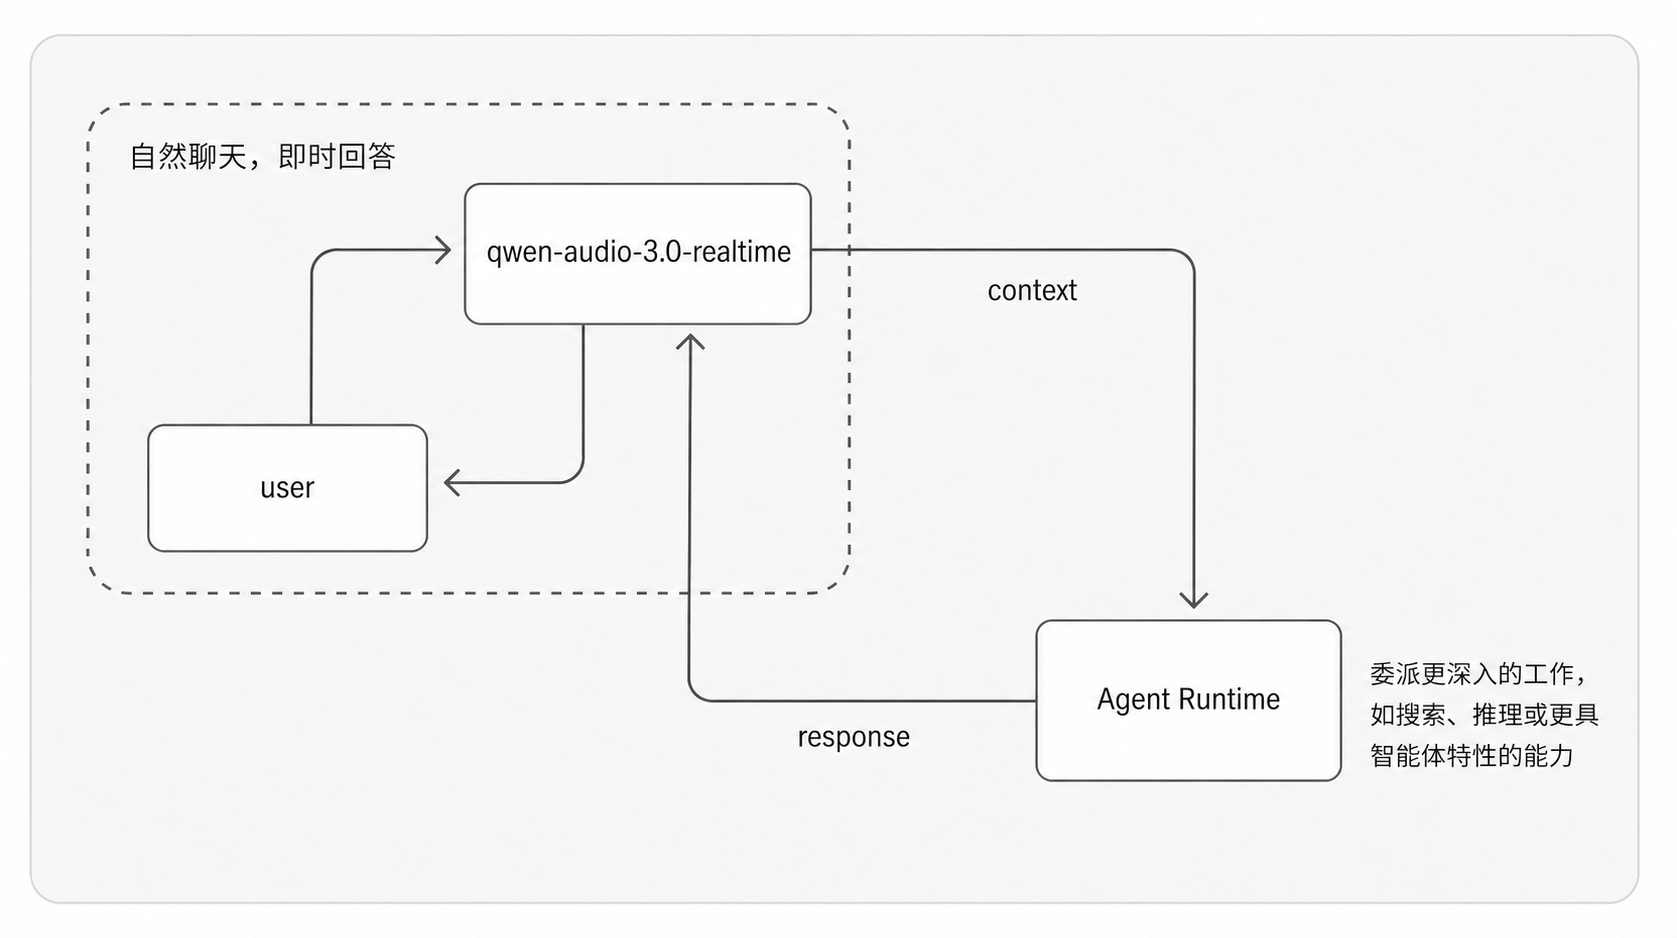
图 1:官方仓库概念图,来源固定提交 docs/architecture-overview.png。它表达的是职责关系,不是实际网络拓扑。
当前实现已经扩展成三层:
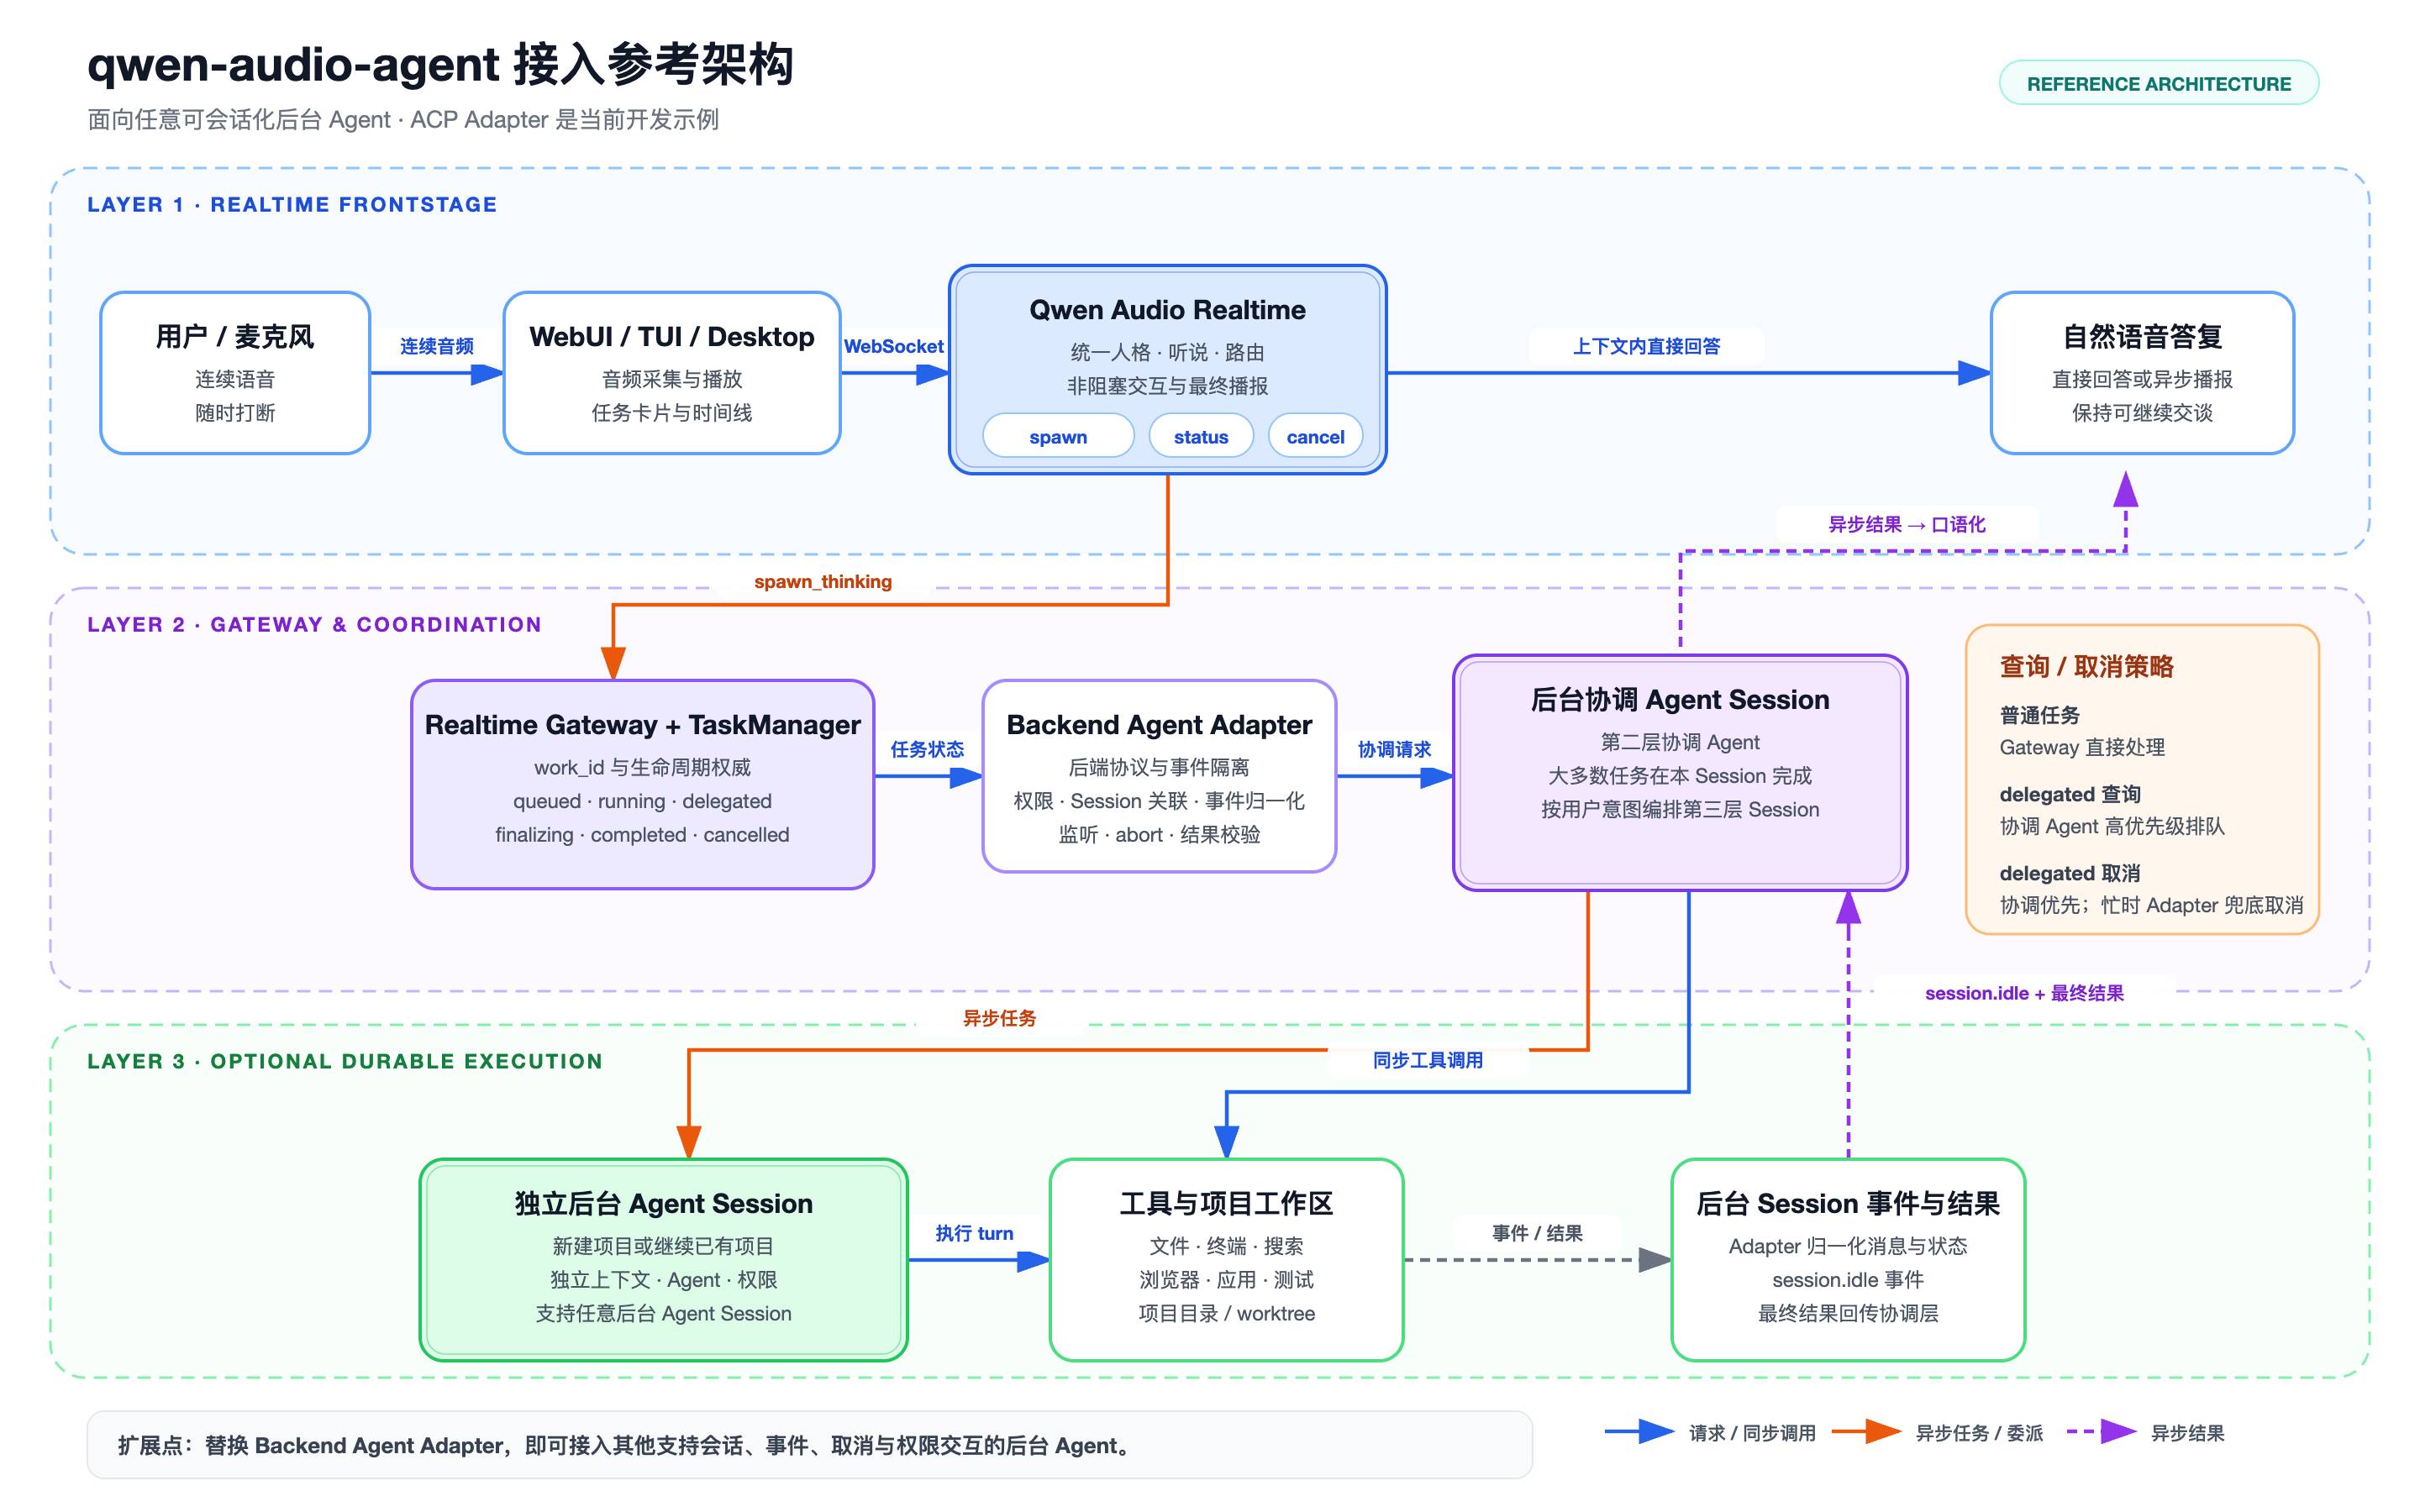
图 2:官方三层参考架构,来源固定提交 docs/qwen-audio-agent-three-layer-architecture.png。第一层是实时前台,第二层是 Gateway 与协调 Agent,第三层是可选的持久执行 Session。
把官方图进一步还原成进程和数据路径,可以看到真正的系统边界:
这里最关键的不是“三层”这个数量,而是三种不同的权威状态:
- Realtime Session 持有当前对话、VAD、短工具循环和即时语音生成。
- Gateway 持有 voice owner、turn generation、播放确认、Task、通知和恢复状态。
- 后台 Agent Session 持有项目目录、工具、长推理和真实执行过程。
系统没有让一个模型 Session 同时承担这三种状态,从而避免长任务占住实时对话。
3.1 从第一性原理看:它实际上在协调两套时钟
语音 Agent 同时面对两个彼此冲突的目标:
- 交互连续性:用户说完后应尽快得到反馈;随时可能插话、改口或取消当前回答;断线后可以重建会话。
- 执行完整性:写文件、运行命令、调用外部工具可能持续数十秒甚至更久;中途可能请求权限、失败重试、委托子会话,并产生不可重复的副作用。
两类工作所需要的系统性质几乎相反:
| 维度 | 前台对话时钟 | 后台工作时钟 |
|---|---|---|
| 典型时间尺度 | 数百毫秒到数秒 | 数秒到数小时 |
| 首要目标 | 低延迟、可打断、自然轮次 | 持久、可审计、可恢复 |
| 主要状态 | 音频缓冲、当前 turn、模型响应 | Task、权限、工具调用、原生 Agent Session |
| 正常失败处理 | 丢弃迟到事件、取消当前响应、重连 | 持久化、对账、重试、明确终态 |
| “取消”的语义 | 停止听到当前回答 | 确认后台工作已经停止 |
如果让同一个 Realtime Session 同时承担这两套时钟,会出现四个结构性问题:
- 长工具调用会占住对话响应通道,用户必须等待后台工作结束才能继续交流。
- 模型上下文会被迫兼任任务数据库,Task ID、权限、重试和投递状态只能依赖提示词维持。
- 断线恢复时,系统无法仅凭一段自然语言判断“工具是否已经执行过”,容易重复产生副作用。
- “用户打断了播报”和“用户取消了任务”会混成同一个动作,导致已经提交的工作被误杀。
因此,spawn_thinking 形成的异步边界首先是一个语义隔离边界,其次才是性能优化:前台保证“还能继续说”,后台保证“事情最终有明确结果”。官方架构约束也明确要求 spawn_thinking 不等待后台完成,而每个 owner 同一时刻只把一个 Task 写入协调器 Session。固定 commit 的架构说明
3.2 Gateway 不是音频转发器,而是协调事实源
从数据通路看,Gateway 位于浏览器、Realtime Provider 与后台 Agent 之间;但它的核心价值不是“转发三种协议”,而是为三个生命周期建立共同的因果关系:
- 身份归属:把 WebSocket 连接、Realtime Session、Task 和后台 Session 收敛到同一个
owner_id。 - 轮次因果:用 generation fence 区分当前 turn 与迟到的 provider 事件,避免旧响应重新夺回新一轮对话。
- 工作事实:为 Task 分配 ID、推进状态机、保存通知、记录权限请求和取消结果。
- 结果对账:只有来自正确原生 Session、正确委托目标、正确生命周期的终态事件,才能完成对应 Task。
这也解释了为什么它不能被替换成一个无状态 WebSocket proxy。模型可以解释用户意图,后台 Agent 可以执行工作,但只有 Gateway 同时看见“谁发起、何时提交、当前处于什么状态、结果是否已经投递”。
一个关键设计判断是:Task 记录只是跨边界的交付凭证,不是后台 Agent 内部任务图的镜像。因此公开 Task 只保留 objective、状态、时间戳、结果和有限错误;后台采用什么工具、是否生成子 Agent、内部如何分步,都留在 BackendPort 之后。这样前台 API 不会随着某个 Agent 框架的内部概念一起膨胀。
同理,progress 事件只是可观测性信号,不是控制面。UI 可以显示“正在工作”“等待授权”,却不能依据某段工具日志或协调器话术自行宣布任务成功。最终完成必须由 Task 状态机和原生终态事件共同确认。
3.3 一份可变状态,只允许一个权威
该实现最值得复用的架构原则,不是“三层”,而是每一种可变事实都有且只有一个写入权威,其他模块只消费投影或事件:
| 状态 / 事实 | 唯一权威 | 其他模块拿到什么 |
|---|---|---|
| 麦克风是否正在采集、音频实际播放到哪里 | Web Client | audio.append、playback.started 等输入与观测事件 |
| 当前对话 turn、是否已被打断 | Gateway 的 Realtime turn state | 带 generation 的 provider 操作与广播 |
| 当前 Session 内的语言理解和自然语言响应 | Realtime Provider Session | 转写、音频增量、tool call |
| Task 生命周期、结果与通知投递 | Gateway TaskManager / notification queue | 有界 public Task 与 conversation event |
| 后台项目上下文、工具状态、原生 Session 历史 | Backend adapter 与后台 Agent | BackendPort 事件和终态结果 |
| 一次权限请求是否被同意 | 当前用户明确表达,经 Gateway 绑定到待决请求 | 有作用域的 authorization response |
| 长期偏好与事实记忆 | USER / MEMORY 上下文 | 注入新 Realtime Session 的只读上下文 |
例如,realtime-turn-state.mjs 把 provider 打断、客户端打断和手工打断都收敛到同一个 generation 边界。它解决的不是“多写几个 if”,而是防止多个调用点各自修改 responseInFlight、currentResponseId 后产生互相矛盾的真相。
同一个原则也贯穿 Task:内部状态可以细分为 scheduled / queued / running / delegated / finalizing / cancelling / completed / failed / cancelled,而客户端的粗粒度 workState 只使用 submitted / working / auth_required,进入终态后才回落到 completed / failed / cancelled。内部状态机负责精确性,公开词汇负责兼容性;两者不应混为一套 API。
3.4 把模型文本降为意图,把协议对象提升为事实
LLM 擅长的是从口语中抽取目标,不擅长充当一致性数据库。Qwen Audio Agent 因而把跨边界信息分成两类:
objective是模型生成的、保守且自包含的自然语言意图。它应包含执行所需事实,但不包含前台人格、闲聊历史或对后台执行计划的指挥。- Task ID、owner、时间戳、路由、权限请求、原生 Session ID 和生命周期是结构化协议对象,不塞进 prompt,也不从模型回复中反向猜测。
这个划分带来三个结果:
- 协调器说“我已经处理好了”并不能完成 Task;系统必须等到可关联的原生终态。
spawn_thinkingtool call 成功只代表 Gateway 接受了工作,不代表后台执行成功。- 旧模型响应、提示词注入或重试生成的不同措辞,不能改变 Task 的真实状态。
这是一条比“使用 JSON”更深的原则:凡是影响幂等、恢复、权限和副作用的字段,都必须脱离概率文本,进入可验证协议。
3.5 用深模块隔离变化,而不是让每层都理解所有协议
从模块边界看,系统在努力把复杂性压进少数“深模块”中。下面的“隐藏内容”是基于固定源码接口的工程归纳:
| 模块 | 内部隐藏的复杂性 | 对外暴露的稳定语义 |
|---|---|---|
| Realtime Provider adapter | OpenAI / DashScope 事件名、音频格式、Session 配置差异 | session、audio、response、tool call、usage |
BackendPort | ACP、A2A 或其他后端方言 | start / submit / status / cancel / respondAuthorization / subscribe / close |
| TaskManager | FIFO、状态转移、持久化、恢复、取消竞态 | 接受工作、读取 Task、观察终态 |
| RealtimeTurnState | response ID、generation、不同打断来源 | 开始响应、结束响应、推进打断边界 |
| TaskNotificationQueue | claim、租约、重试、断线重投、播放确认 | “这个结果是否可由当前前端安全播报” |
依赖方向因此保持单向:UI 只理解公开事件,Realtime 工具只提交目标,TaskManager 只依赖 BackendPort,具体协议被压在 adapter 内。新增 provider 或 backend 时,变化应止于对应适配层;如果 UI 开始认识 ACP Session、Realtime 工具开始 import 某个 backend adapter,就意味着抽象边界已经泄漏。
BackendPort 的另一个细节也很重要:它定义的是完整、协议中立的生命周期表面,后端不支持的可选能力通过 describe() 显式声明,并在调用时明确拒绝。调用方不需要通过“某个方法是否存在”来猜能力。这让能力协商成为协议事实,而不是 JavaScript 对象形状的偶然结果。
3.6 八条可执行的架构原则
| 架构原则 | 在当前实现中的落点 | 主要防止的问题 |
|---|---|---|
| 1. 前台要薄,后台要完整 | Realtime 只保留少量低延迟工具;多步骤工作一律进入 BackendPort | 对话延迟被工具链拖垮 |
| 2. 先任务化,再确认接单 | Gateway 创建并持久化 Task 后,前台才播报“已开始处理” | 口头承诺与真实接单不一致 |
| 3. 一种状态只有一个写入权威 | turn、Task、原生 Session、播放位置分别由不同模块拥有 | 多个布尔量和回调制造竞态 |
| 4. 文本表达意图,结构表达事实 | objective 用自然语言;ID、路由、权限、生命周期用协议字段 | 从模型措辞推断系统真相 |
| 5. 同 owner 串行,独立执行可并行 | 协调器写入保持 FIFO;已委托的目标 Session 释放调度 lane | 同一上下文写乱,同时避免全局阻塞 |
| 6. 能力显式,协议方言向内收缩 | Provider adapter、BackendPort、describe() 能力声明 | 上层绑定单一厂商或靠缺失方法猜测 |
| 7. 不能证明恢复,就明确失败 | 只有 adapter 能验证持久原生 Session 时才重新附着;否则把不安全的中间态标为失败 | 重启后重复副作用或假装仍在运行 |
| 8. 以用户感知完成投递闭环 | 结果领取、播放开始、打断后重投共同决定通知是否完成 | “模型生成完”被误当成“用户听完” |
第 8 条在当前仓库仍只实现到“播放已开始”的粒度,还没有精确到 played_ms;因此它既是已采用的架构方向,也是尚未闭合的工程债务。原则先确立“由客户端听感确认”,具体实现仍需更精确的播放游标与恢复协议。
3.7 这些原则不是免费的
| 选择 | 得到什么 | 付出什么 |
|---|---|---|
| 本地 Gateway 成为协调中心 | 权限、设备和本地文件边界清晰;前端可替换 | 多一次媒体跳转,也形成单机故障域 |
| 每 owner 一个持久协调器 Session | 项目上下文连续,用户心智简单 | 协调器写入必须串行,吞吐受单 lane 限制 |
| self-contained objective | 后台不依赖脆弱的前台聊天历史 | 前台摘要不足时可能丢失执行上下文 |
| 文件持久化 Task 与 memory | 实现简单、可检查、适合个人桌面 | 不适合多实例并发、跨机器一致性和高可用 |
| 隐藏后台内部能力 | UI 与 Agent 框架解耦 | 高级能力无法直接暴露,需设计新的有界公共语义 |
所以这套架构最适合“单用户、本地优先、需要边说边做、后台工作可能较长”的桌面 Agent。若目标变成多租户呼叫中心、跨地域高可用、多人共享同一任务,owner_id、持久化、调度和媒体链路都需要重新设计,不能把当前 Gateway 简单横向复制。
归根结底,它不是把“语音模型”和“工具 Agent”接在一起这么简单,而是把一个易失、低延迟、可打断的对话系统,与一个持久、有副作用、可恢复的工作系统,通过结构化 Task 协议和结果投递协议进行对账。这才是三层架构背后的核心思想。
4. 端到端链路:一段声音经历了什么
4.1 浏览器采集:系统 AEC + 应用层 PCM
WebUI 调用 getUserMedia 时显式请求 echoCancellation、noiseSuppression 和 autoGainControl;随后使用 AudioContext 与 ScriptProcessorNode(2048) 读取单声道浮点采样,线性重采样到 16 kHz,量化成 PCM16,再 Base64 编码为 audio.append 事件送给 Gateway。证据见 useRealtimeVoice.js 与 audio.js。
这条路径的优点是简单、透明、所有控制都在应用层;代价也很具体:
- [工程推断] 采集粒度偏粗。 若设备原生采样率为 48 kHz,2,048 帧回调约对应 42.7 ms,尚未计入重采样、Base64、WebSocket 和 Gateway 转发。
- [源码] 重采样是线性插值。 它足以做可用原型,但不等于高质量、带抗混叠滤波的专业采样率转换器。
- [源码]
ScriptProcessorNode是旧式 Web Audio API。 对实时产品更稳妥的方向是AudioWorklet,把音频处理移出主线程并显式测量 callback jitter。 - [工程推断] Base64 增加约三分之一字节膨胀,并产生 JS 编解码与 GC 压力。 在单用户本地环回场景可能可接受,在移动弱网或多会话服务端则会放大。
4.2 两段 WebSocket,而不是浏览器直连模型
浏览器只连接本机 Gateway;Gateway 再由 DashScope Provider 建立到 wss://dashscope.aliyuncs.com/api-ws/v1/realtime?... 的 Bearer WebSocket。Provider 声明输入 16 kHz PCM、输出 24 kHz PCM,并把内部统一动作映射为 session.update、input_audio_buffer.append、response.create、response.cancel 等协议事件。证据见 dashscope.mjs 与 realtime-provider.mjs。
因此实际音频主路径是:
麦克风 → 浏览器 Web Audio → PCM16/Base64 → 本地 WebSocket
      → Gateway → Provider WebSocket → DashScope Realtime
      → Base64 PCM → Gateway → 浏览器播放队列 → 扬声器
它用一个额外应用层 hop 换来四项收益:API Key 不进入浏览器、协议适配集中、工具和后台任务都在本机可信进程、前端可以在不同 Realtime Provider 之间保持统一事件。相应地,Gateway 也成为媒体、会话和任务的共同故障域;未来若远程部署,必须为它补齐 TLS、反向代理、鉴权、容量隔离和流量背压,不能把默认 loopback 配置直接暴露到公网。
4.3 输出播放:项目真正尊重了“播出来”与“收到了”的区别
浏览器收到 24 kHz PCM delta 后,不是以“网络收到音频”作为已播放事实,而是创建 AudioBufferSourceNode,沿一个单调播放游标安排开始时间。每个 response 维护 source 数量、done 状态和 started/ended 回执;当 AudioContext.currentTime 穿过计划开始点时,客户端向 Gateway 发 playback.started,播放结束或取消时再发对应事件。证据见 useRealtimeVoice.js。
这是仓库中一个很成熟的设计:
- 模型生成完成不等于用户听完。
- 网络收到音频不等于扬声器已经开始播放。
- Task 结果只有在播报真正开始后才可从通知队列确认。
- transcript 可以等到播放开始再进入用户可见时间线,避免字幕领先声音造成“已经说过”的错觉。
但它仍只掌握 response 是否开始、是否结束,没有记录精确的 audible_ms 或词级可听边界。这个差异会直接影响打断后的模型历史。
5. Realtime Provider:不是薄 SDK,而是协议方言防火墙
项目没有让 Gateway 到处判断“这是 DashScope 还是本地 HF 服务”,而是定义统一的 Realtime Provider 能力,并把差异封装在 adapter 内。主要动作包括:
connect/closeupdateSessionsendAudio/sendInputsendToolResultcreateResponse/cancelResponsecapabilities/subscribe
当前有两条主要路径:
| Provider | 下游协议 | 模型链路 | 默认采样率 | 关键边界 |
|---|---|---|---|---|
| DashScope | OpenAI Beta 风格 Realtime WebSocket | Qwen Audio 3.0 或 Qwen3.5 Omni 托管模型 | 16 kHz 入 / 24 kHz 出 | 需要 DashScope Key;模型推理不在本地 |
| speech-to-speech | OpenAI GA 风格本地 WebSocket | VAD → STT → LLM → TTS,由服务端配置 | 16 kHz 入 / 24 kHz 出 | 可全本地;不是原生端到端音频模型的等价实现 |
项目把 session ack、单 response 槽、metadata correlation、per-response instructions、item ID echo 等差异做成 capability,而不是按 Provider 名称散落分支。对于本地 speech-to-speech 服务的 “response slot busy” 与 “input busy”,实现会用 1.2/2.6/5 秒退避重发原 payload,避免并发响应槽把队列永久卡死。
模型目录也比 README 的一句“支持 Qwen”更具体:固定提交列出 qwen-audio-3.0-realtime-plus/flash 与 qwen3.5-omni-plus/flash-realtime,并为 Audio 与 Omni 家族配置不同默认 voice 和 turn detection。Omni profile 声明模型可以接收 image,但 transport capability 仍关闭 image,因此当前 WebUI/TUI 到 Gateway 的实时图像链路并未完成。证据见 realtime-model-catalog.mjs。
6. 自然打断:做对了三件半,还缺最难的半件
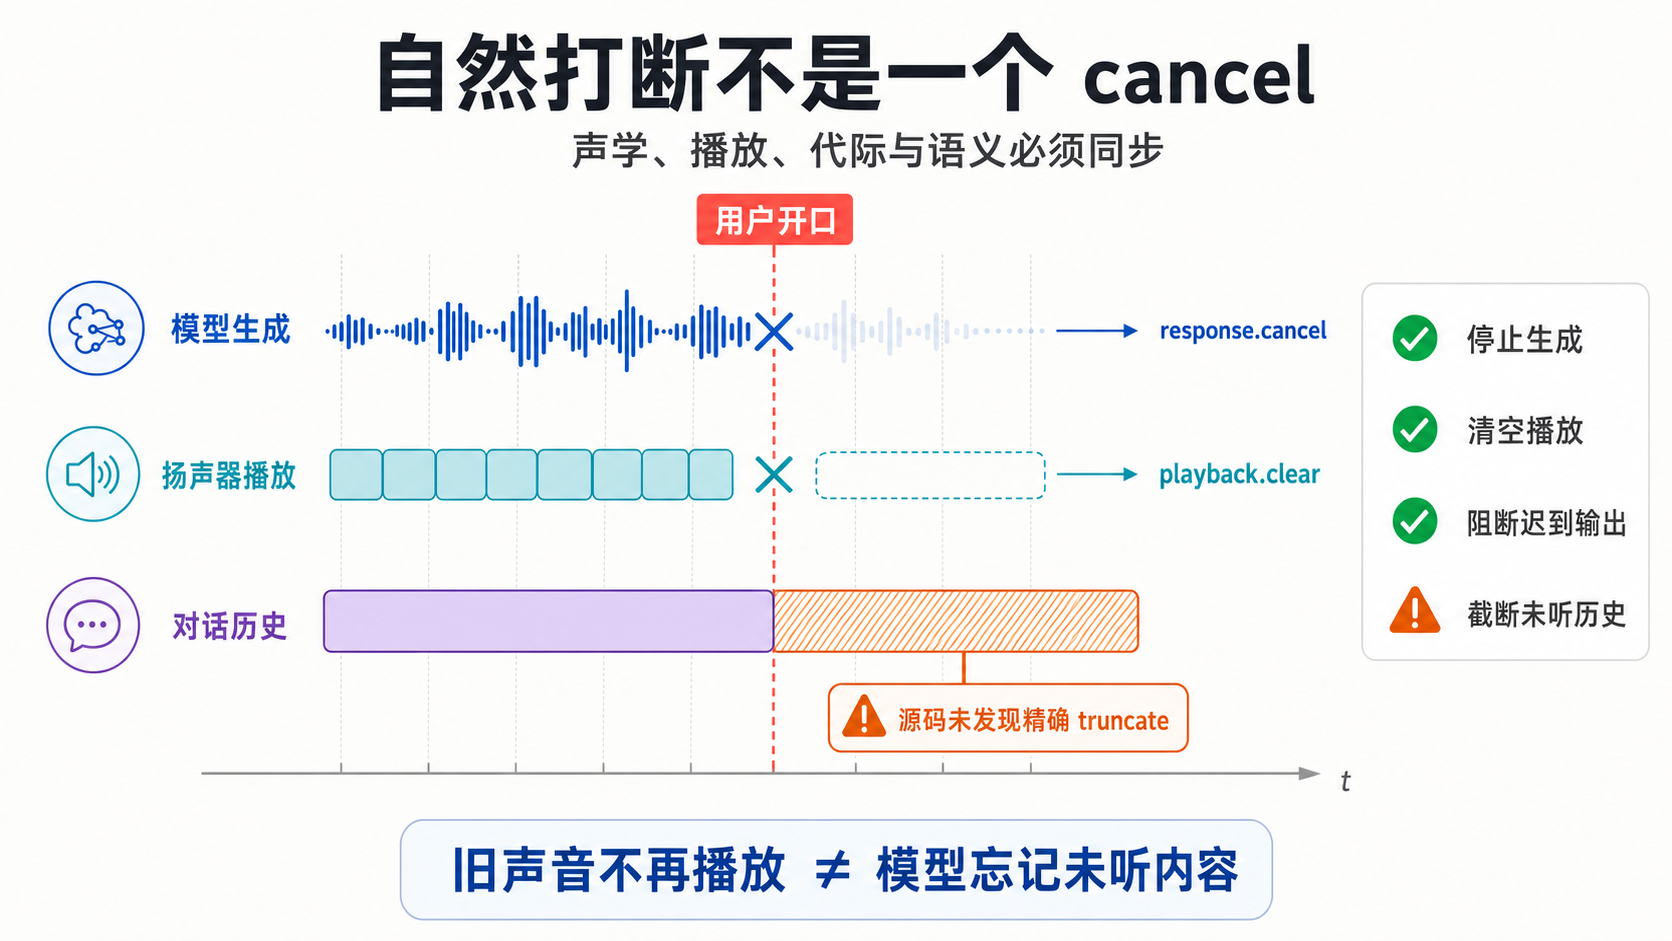
ImageGen 信息图:停止生成、清空播放和阻断迟到输出不等于截断未听历史;橙色部分表示固定源码中未找到精确 truncate 的证据。
6.1 已实现的四步状态迁移
当 Provider 发出 input_audio_buffer.speech_started 时,Gateway 会开启新 turn、撤销正在等待的结果播报、向客户端发送 playback.clear,并调用 Realtime Provider 的 cancel。浏览器收到 clear 后停止全部相关 AudioBufferSourceNode、清空队列并上报 playback.cancelled。Gateway 同时推进 turn generation,并把旧 response 标为 suppressed,使迟到的 audio/text 不再进入当前展示。证据见 realtime-input-runtime.mjs、realtime-presentation-runtime.mjs 与客户端 stopPlayback。
对应四种同步分别是:
- 生成同步:
response.cancel停止 Provider 继续生成。 - 物理同步:
playback.clear真正清空客户端扬声器队列。 - 代际同步:turn generation / response ID 拒绝旧轮次迟到输出。
- UI 同步:播放回执让 Gateway 知道用户侧实际发生了什么。
仅有 response.cancel 不够,因为已经下发的音频仍可能在客户端排队;仅清播放器也不够,因为模型可能继续生成并把未听内容写入 conversation。Qwen Audio Agent 已经明确处理了前一个问题,也用 suppression 缓解迟到展示。
6.2 缺失证据:没有把模型历史截到“用户实际听到的位置”
对固定 commit 全仓搜索,没有发现 conversation.item.truncate、audio_end_ms 或等价的“按可听毫秒数截断 assistant item”实现。项目知道某个 response 已开始、已结束或被取消,却不知道用户在第几毫秒被打断,也没有向远端 conversation 回写这个精确边界。
这意味着:
- [源码] 客户端不会继续播放旧声音;旧 response 的迟到片段也不会继续展示。
- [工程推断] 远端模型的 conversation 仍可能保留一部分用户从未听到的 assistant 内容。
- [工程推断] 下一轮模型可能引用那段未听内容,形成“我明明没说完,但模型认为你听过”的语义漂移。
阿里云官方文档同样建议在 speech_started 时立即清空本地播放缓冲;这解决的是物理层。若 Provider 协议支持 conversation item truncation,项目下一步应把浏览器的真实播放游标提升为精确 played_samples,再通过 Gateway 映射到 assistant item 的可听终点。若 Provider 不支持,至少要在自己的 conversation projection 中只重放“确认可听”的文本,而不是完整生成。
6.3 AEC 不是跨端一致能力
WebUI 请求浏览器 AEC/NS/AGC;macOS TUI 有原生 CoreAudio 路径;仓库 README 明确提醒 Linux/Windows 在无回声消除的全双工模式下使用耳机。因此“支持全双工”应分成两层理解:协议和状态机支持同时听说,不代表每个终端在扬声器外放时都能得到可用的声学双讲。
真正的设备验收至少要覆盖:Mac 内置扬声器、USB 耳麦、蓝牙耳机、Windows/Linux 外放、远场麦克风,以及 0.5–3 米距离下的自回声误触发率、打断首停延迟和漏字率。
7. 前台工具:让 Realtime 模型只做短而有界的事
Realtime 模型并非只聊天。Gateway 暴露一组前台工具:时间、记忆、笔记、提醒、任务查询/取消、权限回应,以及可选的 Web、知识、MCP 与 OpenAPI 工具。工具循环有明确上限:单 turn 最多 12 次调用、30 秒执行预算和结果字节限制。
这组设计背后的原则是 Realtime Session 只承担可快速结束、可向用户解释、可被取消的工作。真正可能占用文件系统、终端、搜索、测试或长推理的任务统一走 spawn_thinking。
spawn_thinking 本身不是把整个前台对话交给后台,而是创建一个自包含 objective,立即返回 accepted。它的 backend lane 使用 backend:${ownerId} 且 laneLimit = 1,保证同一 owner 的后台协调 Agent 不被并发 turn 撕裂;全局 TaskScheduler 仍可对不同 lane 并行。证据见 spawn-thinking-tool.mjs 与 tool-call-handler.mjs。
这比“Realtime 模型直接运行任意工具”稳健,原因是:
- 语音前台不必等待后台终端和测试结束。
- 同一用户仍可继续插话、问新问题、查询或取消任务。
- 后台任务拥有独立 ID、生命周期、权限请求和持久结果。
- Realtime 模型拿到的是结构化完成事实,而不是假设某项工作已完成。
8. TaskManager:项目最有价值的深模块
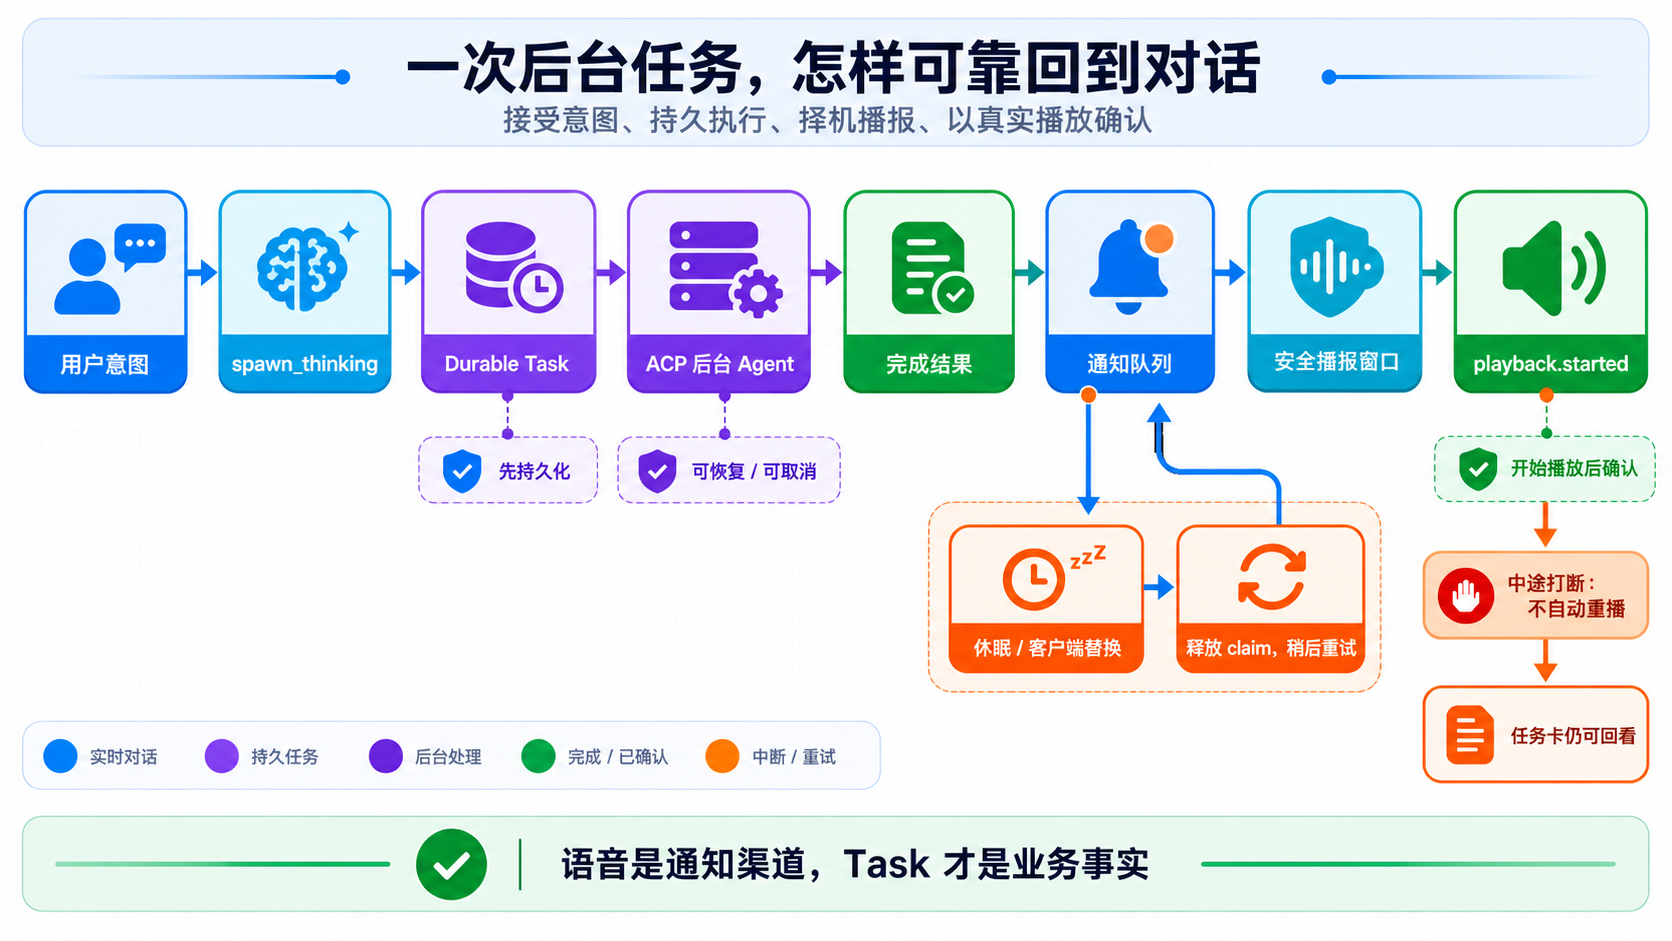
ImageGen 信息图:任务先持久执行,再择机播报;播放开始前可释放 claim 重试,开始播放后不自动重播,重要结果仍由任务卡承载。
8.1 状态不是一个 Promise
Task 的公开状态被收敛为 submitted / working / auth_required / completed / failed / cancelled;内部则保留 scheduled / queued / running / delegated / finalizing / cancelling 等更细阶段。内部细节可以演进,对客户端协议保持稳定。证据见 task-state.mjs。
状态机的工程价值在于把“模型说正在做”与“系统真实在做”分开。任务进度由 Gateway/Backend observation 驱动;语音模型只是解释者,不是执行事实源。
8.2 重启恢复不是把所有 running 都伪装成继续运行
恢复策略是保守的:scheduled 任务重新调度;支持原生 reattach 的 delegated 任务可以接回;queued/running 这类无法证明外部执行状态的任务会失败收敛;cancelling 保留取消语义;持久通知恢复为待投递。Session journal 还可以补齐 Task projection。
这是正确的安全取舍。崩溃后无条件重跑会重复写文件、发消息或执行命令;无条件宣称继续则会制造幽灵任务。只有后台 adapter 能提供稳定 native work/session identity 时,reattach 才有资格发生。
8.3 通知队列是“近似 exactly-once”,不是一句完成回调
Task 完成后,结果进入持久通知队列。投递者通过 claim lease 领取;生成结果播报后,只有客户端确认 playback.started 才把通知标为 delivered;未开始播放、超时、客户端被替换或进入 sleep 时可以释放 claim 并重试。证据见 task-notification-queue.mjs 与结果播报测试覆盖。
这里有一个值得明确的产品语义:一旦播报 开始,通知就视为 delivered;若用户在中途打断,系统不会自动从头重播。因此它防止了崩溃后的重复播报,却不是“用户完整听完一次”的 exactly-once。更准确的说法是:在第一次可听起点前可重试,开始可听后至多播报一次。若任务结果很重要,UI 中必须保留可回看的任务卡片,语音不应是唯一交付渠道。
9. BackendPort 与 ACP:让后台 Agent 成为可替换执行引擎
BackendPort 定义 describe / start / health / submit / status / cancel / respondAuthorization / subscribe / close,把 Gateway 的 Work/Task 语义与 ACP、A2A 或自定义后端协议隔离。证据见 backend-port.mjs。
ACP adapter 为每个 owner/backend 维护一个持久协调 Session,逻辑身份形如 qwen-audio-agent:<owner>:backend,同时持久化原生 ACP session ID。协调 Session 负责理解 objective、创建或续接项目 Session;真正的项目文件、工具和长期上下文留在后台 Agent 自己的原生历史里。证据见 acp-session-registry.mjs。
这个边界有三个重要效果:
- Realtime 对话不会把全部闲聊、音频 transcript 和个人偏好无差别塞进编码 Agent。
- 后台可以复用 Codex、Claude Code、Qwen Code、OpenCode、OpenClaw 等既有环境、工具、MCP、Skills 与认证。
- Gateway 只依赖协议中性的 Work,不需要理解每个 Agent 的内部 Session 结构。
代价是 objective 必须足够自包含。如果前台模型省略关键约束,后台不会自动拥有完整语音上下文。高风险任务应把目标、工作区、禁止事项、验收条件和附件都结构化进入 Work,而不是依赖一句自然语言摘要。
10. 权限:自然语言确认可用,但不能被神化成安全证明
后台 Agent 请求权限时,adapter 把请求归一化为 owner-scoped Task 事件;Realtime 模型负责把它口语化,并理解用户的允许/拒绝。always 只影响当前前台 Session 的策略,adapter 对后台仍选择尽可能窄的一次性权限;前台外部可写 MCP/OpenAPI 工具也要求批准。
这是比“所有工具默认全开”更正确的方向,但语音确认天然有额外威胁:
- ASR 误识别“不要”与“要”。
- 扬声器回声或旁人语音触发确认。
- Prompt injection 诱导模型用模糊措辞包装真实副作用。
- 用户只听到摘要,没有看到命令、路径、金额或接收方。
因此权限应按风险分级:
| 风险 | 推荐交互 |
|---|---|
| 只读、可撤销、局部 | 语音自然确认可接受,并保留可见任务卡 |
| 写文件、执行命令、修改配置 | 语音 + 屏幕显示具体 scope;确认绑定 Task ID 与参数摘要 |
| 删除、付款、发布、外部消息、凭据操作 | 不允许仅靠自由语音确认;要求点击、系统认证或第二因素 |
仓库默认 Gateway 绑定 loopback,并对 Origin/Host 做同源和 DNS rebinding 防护;本地 identity secret 要求足够长度。证据见 request-security.mjs。这是个人本地运行的合理基线,却不是远程多租户安全模型。
11. 记忆、休眠和多客户端:桌面产品需要的非模型状态
11.1 记忆分层
项目把 ASSISTANT.md 用作人格与行为设定,USER.md 用作用户偏好,MEMORY.md 只保存事实。显式 memory tool 使用原子读写、追加和唯一替换,并过滤敏感内容;可选的会后提取由独立文本模型执行并记录审计。
这比把所有东西塞进 Realtime conversation 更可控:conversation 是短期交互状态,用户偏好是指令权威,事实记忆是可编辑持久数据,后台项目历史又属于另一个 Session。四者不应该互相冒充。
11.2 睡眠不会杀掉后台工作
桌面休眠时关闭云端 Realtime 连接,但 Gateway 与已提交 Task 继续运行;本地 sherpa-onnx 唤醒词仍可工作。醒来后再连接前台,并投递休眠期间完成的结果。麦克风音频在休眠时只在本地参与 wake detection,不继续送云端。
这正好验证了“双时间尺度”不是一句产品文案:Realtime Session 可以短命,Task 与通知必须长命。
11.3 一个 active voice owner
Gateway 显式仲裁 WebUI、TUI、Desktop 的语音所有权:只有一个 active voice client 能采集和接收语音;替换需要 takeover,旧客户端不能释放新 owner。纯文本客户端不抢占语音,input-muted 可以保留播放。这避免两个窗口同时上送麦克风、重复播放或争抢结果通知。
12. 可靠性:已经有状态机,但还缺生产媒体系统的闭环
12.1 已有机制
- Provider 输出队列串行化
response.create,适配单 response 槽。 - response start watchdog 与 inactivity watchdog 发现模型不响应。
- cancel 后保留短 grace period,吸收迟到终局事件。
- Provider 重连采用退避;未连接时只保留有限音频 chunk,并丢弃最旧项。
- Task、Session、通知和 ACP native identity 都有持久恢复语义。
- JSONL 日志继承关联字段、限制大小并递归脱敏常见凭据。
- 测试覆盖结果投递、sleep、client replacement、权限暂停、ACP reattach、任务取消、日志脱敏和 Gateway lease 等大量故障路径。
12.2 仍需补齐
- 音频时序指标:采集 callback jitter、Gateway 排队、Provider RTT、首音、播放 underrun、打断到静音、迟到音频丢弃量。
- 精确可听账本:response → item → chunk → played sample 的关联,以及截断或 projection 策略。
- 断线音频策略:当前有限 chunk 缓冲避免无限增长,但重连后发送旧语音是否仍符合用户意图,需要 TTL 和 turn-aware 丢弃规则。
- 分布式存储:本地文件适合单机个人 runtime;多实例需要有版本的 durable store、租约、幂等键和 owner 分片。
- 媒体承载能力:没有 WebRTC jitter buffer、拥塞控制、Opus、TURN、SIP、多参与者或 SFU。
- 生产可观测:结构化日志已具备,但没有看到完整 OpenTelemetry trace、媒体 QoE dashboard、SLO 和自动故障注入闭环。
13. 与 OpenAI Realtime 参考架构逐层对照
以下对照以 [OpenAI Realtime API 报告](/reports/20260823_OpenAI Realtime API 端到端实现逆向分析:从客户端音频到实时语音模型/) 为基线。两者不是同一层产品:OpenAI Realtime 是托管模型与实时协议;qwen-audio-agent 是可以调用不同模型和后台 Agent 的本地产品 runtime。
| 维度 | OpenAI Realtime 参考架构 | qwen-audio-agent 固定提交 | 判断 |
|---|---|---|---|
| 产品边界 | 托管 Realtime 模型/API;应用自建客户端与业务后端 | 开源本地 Gateway、客户端、任务与 Agent adapter;默认模型托管 | Qwen 项目开放的是 runtime,不是默认模型权重 |
| 浏览器媒体 | 推荐客户端直连 Provider WebRTC,后端 sideband 控制 | 浏览器 WebSocket 到本机 Gateway,再 WebSocket 到 Provider | OpenAI 路径更短;Qwen 控制更集中、Provider 更可替换 |
| 音频承载 | WebRTC RTP 或 WebSocket PCM;另有 SIP | 当前项目采用 PCM16 Base64 over WebSocket | 易调试但缺 WebRTC 媒体栈的拥塞、抖动、Opus 与 NAT 能力 |
| 客户端声学 | WebRTC/browser AEC、NS、AGC;设备实现决定质量 | Web 请求同类约束;部分 TUI 平台无 AEC | 都必须真机测;Qwen 跨平台外放双讲边界更明确 |
| Session 控制 | Client media + server sideband 可共同控制同一 Session | Gateway 是媒体与控制的完整代理和 Session owner | Qwen 更像本地 Session Actor;Gateway 故障域更大 |
| VAD | server_vad / semantic_vad | Audio 模型 smart_turn,Omni semantic_vad,本地链路 server_vad | Provider capability 显式化是优点 |
| 打断 | cancel + client flush + conversation truncation / 可听历史 | cancel + playback.clear + generation fence;未发现精确 item truncate | 物理打断可靠性较好,语义截断仍是核心缺口 |
| 工具 | Function Calling / MCP,应用执行与回填 | 有界前台工具 + spawn_thinking + ACP/A2A BackendPort | Qwen 对长任务和既有 Agent 的实现更完整 |
| 长任务 | 需要应用自己构建 Job/Memory/通知 | TaskManager、scheduler、恢复、claim lease、语音播报已内建 | 这是 Qwen 项目最强的差异化能力 |
| 权限 | 应用在 sideband/业务层自建策略与确认 | Task 权限状态、自然语音确认、backend permission mode | Qwen 有产品闭环;高风险仍需非语音第二确认 |
| 结果交付 | 应用决定如何把业务结果写回 Session | 安全双工窗口注入结果,tool_choice=none,播放开始后确认通知 | 因果链更完整;中途打断后不重播需 UI 兜底 |
| 电话与多人 | 支持 SIP;可与媒体平台组合 | 无 SIP、Room、SFU 或多参与者模型 | 不适合直接承担呼叫中心和多人房间 |
| 自托管 | 应用可自托管,模型不可 | runtime 可自托管;默认模型不可;本地 S2S 可替换 | “开源/本地”必须按层表述 |
| 远程生产 | Provider 管理媒体边缘;应用管理业务面 | 默认 127.0.0.1 的个人身份与本地文件状态 | Qwen 适合桌面单用户,远程多租户需要重新设计边界 |
13.1 不是谁“更先进”,而是中心化位置不同
OpenAI 推荐的 WebRTC + sideband 把低延迟媒体交给 Provider,把私有工具与业务状态留在自有后端;qwen-audio-agent 则把 Gateway 放在所有音频、控制和任务之前。前者的权威中心在 Provider Session 与业务 sideband 的协作,后者的权威中心在本地 Gateway。
对于个人桌面编码 Agent,Qwen 的选择很合理:多一个 loopback hop 换来凭据、工具、后台 CLI、任务卡和休眠恢复都在本机。对于移动端、全球弱网、电话、多方会议,媒体应优先迁移到 WebRTC/SIP/SFU,Gateway 退回控制面与任务面,而不是继续中继所有 Base64 PCM。
13.2 Qwen 真正补上了 OpenAI 报告里的“业务行动面”
OpenAI Realtime 协议能表达 function call,但“长任务如何排队、崩溃后如何恢复、如何取消后台 Agent、何时向用户播报、播报前崩溃会不会丢”仍由应用实现。qwen-audio-agent 已经给出一套可运行答案:
Realtime tool intent
  → Gateway Work
  → durable Task
  → owner lane
  → BackendPort
  → persistent ACP coordinator
  → project Agent session
  → terminal result
  → claimed notification
  → safe duplex window
  → Realtime natural-language announcement
  → playback-start acknowledgement
这条链比模型能力本身更可迁移。即使替换为 OpenAI、Gemini、另一款 Qwen 模型或本地级联语音服务,Task/Backend/Notification 的契约仍成立。
14. 适用场景与不适用场景
14.1 当前很适合
- 单用户 macOS 桌面语音编码助手。
- 本地 WebUI/TUI 给既有 Codex、Claude Code、Qwen Code、OpenCode 等增加连续语音前台。
- 需要“继续聊天,同时后台跑测试/搜索/改代码”的个人工作流。
- 需要本地权限、文件、终端和记忆边界,但可以接受云端 Realtime 模型。
- 研究 Realtime 前台与持久 Agent 后台如何解耦。
14.2 需要改造后才适合
- 企业内网多人使用:需要多租户身份、集中存储、审计、配额、密钥管理与实例路由。
- 移动端弱网:需要 WebRTC/Opus、网络切换、后台音频策略、移动功耗和系统中断处理。
- 远场音箱:需要设备级 AEC reference、阵列波束、double-talk 测试和声学校准。
- 关键业务执行:需要屏幕确认、策略引擎、事务 outbox、强幂等和外部审计。
14.3 不应直接承担
- SIP 呼叫中心。
- 多参与者会议或房间。
- 全球边缘实时媒体平台。
- 仅凭“仓库开源”就要求模型权重、推理或数据路径完全本地的场景。
15. 如果把它推进生产,建议按四个切片演进
Slice 1:先把可听历史做成真相
- 客户端记录每个 response 的实际 scheduled/start/played samples。
- 回执增加
played_ms,Gateway 维护 response → item 映射。 - Provider 支持时执行 conversation item truncate;不支持时维护可听 projection。
- 故障注入:打断时同时制造迟到 audio delta、乱序 done、客户端卡顿与重连。
验收门:任意位置打断 1,000 次,旧音频不复活;下一轮不引用未听内容;客户端与 Gateway 的可听边界误差有明确 P95。
Slice 2:升级浏览器媒体
- 先把
ScriptProcessorNode迁到AudioWorklet,引入高质量重采样和 callback jitter 指标。 - 为远程/移动入口增加 WebRTC;Gateway 保留 DataChannel/sideband 控制,不再中继所有 PCM。
- 保留 WebSocket 作为服务端原始媒体和本地调试路径。
验收门:在 Wi-Fi 抖动、5% 丢包和网络切换下测 P50/P95 首音、播放 underrun、打断到静音与恢复时间。
Slice 3:把 Task durable 语义外置
- 将 Task、Session journal、notification、ACP registry 抽象为版本化 DurableStore。
- 写副作用统一带 idempotency key;恢复以 native identity/外部查询为准。
- 对 notification 明确 delivered、heard-started、heard-completed 的产品语义。
验收门:在 create、delegate、permission、finalize、announcement 五个位置逐点 kill Gateway,任务不重复执行、不静默丢失,终态可解释。
Slice 4:权限与观测成为独立平面
- 风险策略不由 Realtime 模型自由决定,建立 typed capability、scope、policy result 和 audit record。
- 高风险操作使用点击/生物认证/第二因素。
- 建立跨客户端、Gateway、Provider、Task、Backend 的 trace ID。
- dashboard 至少覆盖声学、媒体、轮次、模型、播放、工具和任务七段。
验收门:任何真实副作用都能回答“谁、何时、听到了什么、批准了什么参数、哪个 Agent 执行、外部系统返回什么”。
16. 最终判断
如果只看 README,qwen-audio-agent 像一个“给编码 Agent 加语音”的产品;看完源码后,更准确的判断是:它在实现一个 以本地 Gateway 为权威、以 Realtime 模型为交互前台、以既有 Agent Session 为持久执行后台的双速运行时。
它最好的模块是 TaskManager、BackendPort、ACP Session registry 和结果通知协议,因为这些模块把“对话继续,任务也继续”从口号变成可恢复状态机。它在播放生命周期、active voice owner、sleep/wake 与迟到输出抑制上也已经超过普通语音 demo。
它当前最需要警惕的不是模型能力,而是三个系统边界:
- WebSocket PCM 中继适合本地个人 runtime,不等于生产级媒体平面。
- 打断已经停止声音和旧展示,但没有证据证明远端模型历史被截到真实可听位置。
- 自然语言权限确认改善了体验,却不能成为高风险操作的唯一安全门。
因此,与 OpenAI Realtime 报告相比,Qwen Audio Agent 不是一个同层替代品。OpenAI 给出的是低延迟托管模型与媒体/会话协议;Qwen 项目给出的是模型外的本地 Agent 产品骨架。最佳组合甚至可能是:WebRTC Realtime Provider 负责媒体和即时对话,qwen-audio-agent 式 Gateway/Task/BackendPort 负责长期工作、权限、恢复和结果交付。真正可迁移的价值,正是这两层可以彼此替换,而不必绑死在某一个语音模型上。
17. 验收矩阵
| 能力 | 本次证据 | 当前结论 | 仍需验证 |
|---|---|---|---|
| Web 构建 | npm ci 触发 Vite build 成功 | 通过 | 官方支持 Node 版本重跑 |
| 全仓测试 | 1,344 项;1,343 pass、1 skip、0 fail | 通过 | 跳过项与 Provider live test |
| 浏览器采集 | 源码确认 AEC/NS/AGC、2,048 帧、16 kHz PCM | 静态确认 | 多设备 callback jitter 与声学质量 |
| DashScope 链路 | Provider URL、协议和采样率源码确认 | 静态确认 | 真实 Key、长会话、限流与区域故障 |
| 播放生命周期 | source scheduling 与 started/ended/cancelled 测试 | 实现充分 | 真实设备播放时钟误差 |
| 自然打断 | cancel、clear、generation suppression 有源码和测试 | 物理/展示层较完整 | 精确可听历史与远端 item truncate |
| Task 恢复 | 状态机、journal、reattach、通知 lease 有测试 | 实现充分 | 真实进程 kill 与外部副作用重复 |
| ACP 后台 | conformance、Session 恢复、权限和 cancel 大量测试 | 实现充分 | 各 Agent 真实版本兼容矩阵 |
| 权限 | Task 级权限流程与 adapter 归一化 | 可用基线 | ASR 误确认、旁人注入与高风险二次认证 |
| 隐私安全 | loopback、同源、secret、日志脱敏 | 单机基线 | 远程部署、集中审计、密钥轮换 |
| 全双工声学 | Web browser constraints;平台边界有文档 | 未完成统一证明 | Linux/Windows 外放、远场和蓝牙设备 |
| 生产规模 | 本地文件状态与单 Gateway lease | 未证明 | 多租户、HA、容量、SLO、压测 |
Source Manifest
原始来源
| 来源 | 固定版本 / 时间 | 用途 |
|---|---|---|
| QwenAudio/qwen-audio-agent | commit 8565c03c6df6786642be03368a73db357331efe0, 2026-08-28 | README、架构、Web/TUI/Desktop、Gateway、Provider、Task、ACP、权限、记忆、安全与测试的主要证据 |
| README_ZH.md | 同上 | 产品定位、开发态版本、平台和安全声明 |
| Architecture | 同上 | 三层职责、任务协调和 adapter 边界 |
| Alibaba Cloud Qwen Audio Realtime | 访问于 2026-08-28 | 官方模型、协议、音频 chunk 与打断建议 |
| Alibaba Cloud Qwen Omni Realtime | 访问于 2026-08-28 | WebSocket/WebRTC、RTP、VAD 与多模态协议边界 |
| OpenAI Realtime API 报告 | 2026-08-23 | 对照媒体、Session、打断、工具、sideband 和生产边界 |
| LiveKit 实现解剖 | 2026-08-23 | 对照 Room/SFU、Agent runtime、播放与可听历史 |
复用素材
| 本地文件 | 原始来源 | 许可 | SHA-256 |
|---|---|---|---|
outputs/reports/assets/Qwen-Audio-Agent-端到端实现/official/architecture-overview.png | docs/architecture-overview.png | 仓库 Apache-2.0;未做内容修改 | 747e4ce514e6491d6d9cf1a5242e6073629b9a2674ddc70ec285214bb45ec6f9 |
outputs/reports/assets/Qwen-Audio-Agent-端到端实现/official/qwen-audio-agent-three-layer-architecture.png | docs/qwen-audio-agent-three-layer-architecture.png | 仓库 Apache-2.0;未做内容修改 | eb309771be0c4be5fbef03e6d5bdc831741b28b57de3eebc7ad44dfb013c31fd |


生成素材
- ImageGen Manifest — 记录 3 张原创信息图的最终提示词、生成/修订过程、尺寸、SHA-256、机械铺底和逐张视觉验收。
产物清单
- 本报告:
outputs/reports/20260828_Qwen Audio Agent 端到端实现解剖:从本地音频 Gateway 到异步后台 Agent.md - 官方素材副本:
outputs/reports/assets/Qwen-Audio-Agent-端到端实现/official/ - ImageGen 信息图与 Manifest:
outputs/reports/assets/Qwen-Audio-Agent-端到端实现/generated/ - 更新综合页:
synthesis/实时语音 Agent 端到端架构.md - 更新登记:
index.md、log.md
关键决策
- 将项目定义为开源 Agent runtime,而非开源 Qwen Audio 模型实现。
- 用固定 commit 而非浮动
main做源码引用;同时明确其处于v2.0.0开发态、根包仍为1.11.0。 - 将“三层组件说明”进一步解释为双速时钟、Gateway 协调事实源、单一状态权威、文本意图与结构化事实分离、深模块隔离变化等架构原则;源码事实与工程归纳在正文中分开表述。
- 复用官方两张架构图,仅复制并校验哈希,不改写图中事实。
- 新增三张职责独立的 ImageGen 信息图,只视觉化正文已经建立的双速架构、自然打断边界和任务结果交付,不将生成图当作源码或运行证据。
- 不做失真的全局评分;按媒体、会话、任务、权限和部署职责与 OpenAI Realtime 对照。
- 将未发现 conversation item 精确截断列为证据缺口,而不是宣称项目一定无法处理任何语义历史。
验证命令与结果
git rev-parse HEAD
  8565c03c6df6786642be03368a73db357331efe0

npm ci
  Web Vite build 成功;安装 620 packages;audit 0 vulnerabilities

npm test
  root:    80 tests, 79 pass, 1 skip, 0 fail
  server: 758 tests, 758 pass, 0 fail
  web:     96 tests, 96 pass, 0 fail
  tui:     56 tests, 56 pass, 0 fail
  desktop:211 tests, 211 pass, 0 fail
  cli:    143 tests, 143 pass, 0 fail
  total: 1,344 tests, 1,343 pass, 1 skip, 0 fail
未解决风险
- 未执行真实 DashScope 或本地 speech-to-speech 建连。
- 未验证真实声学全双工、弱网、移动网络切换和多小时稳定性。
- 测试环境 Node 25 不在项目声明的官方支持区间。
- 固定提交属于开发态 main,未来 release 可能改变协议和模块边界。
- 官方仓库素材依照仓库 Apache-2.0 复用;再发布时应保留来源与许可证说明。